publications
2026
-
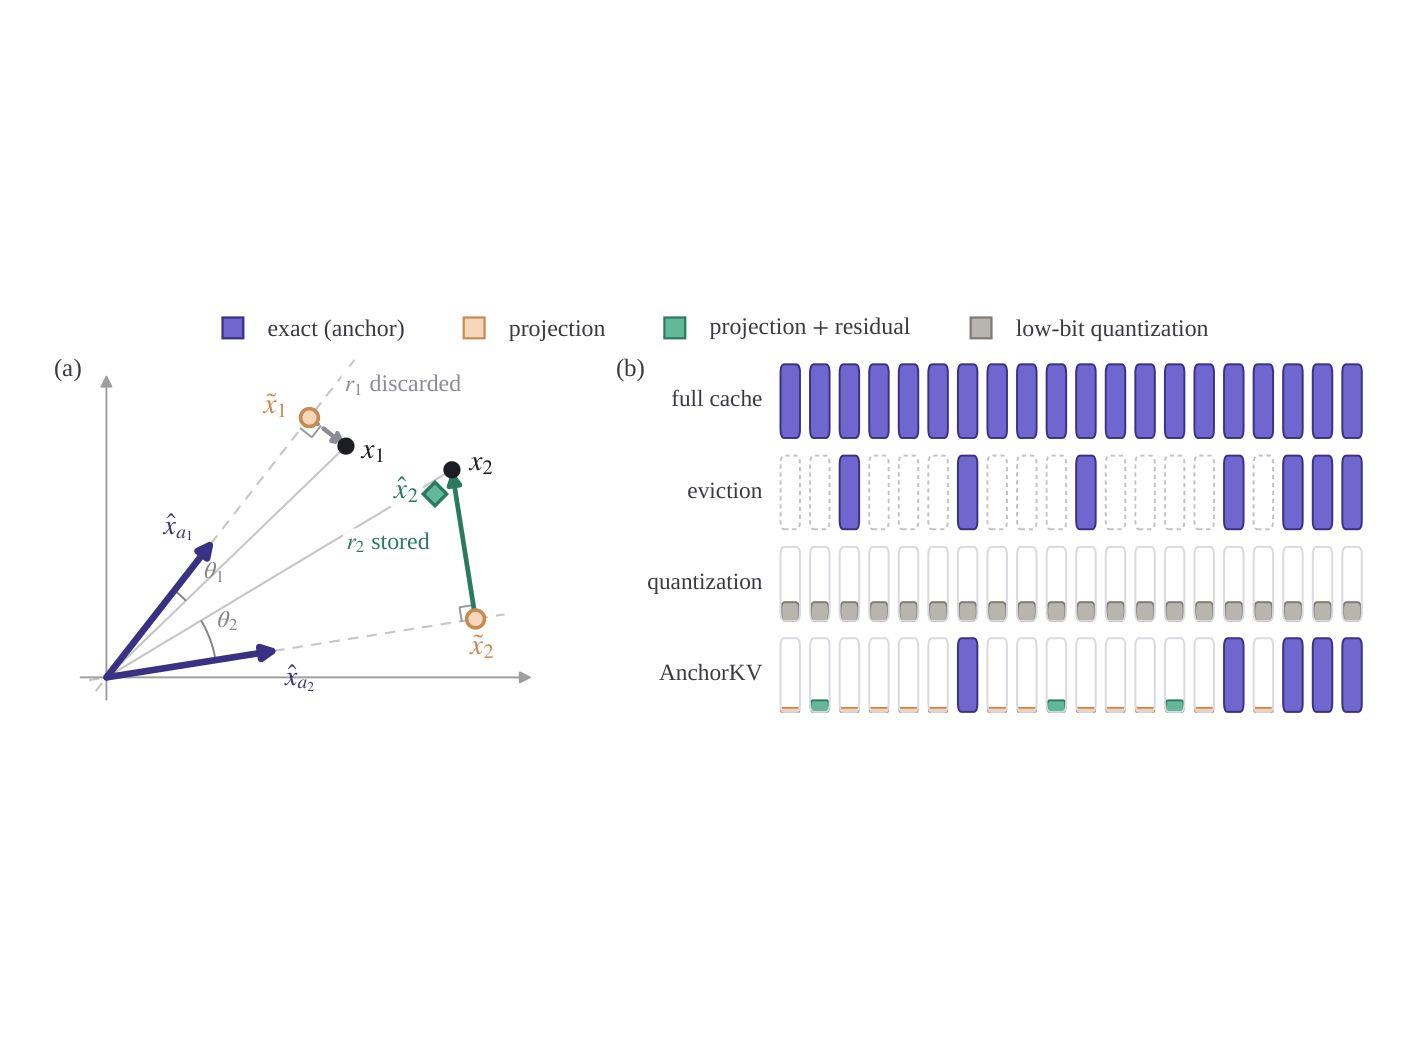 AnchorKV: Anchor-Residual KV Cache Compression
-
 MACRO: Training-free Multi-plane Attention for Closeup Render Optimization
-
 QKV Projections Require a Fraction of Their Memory
2025
-
 CompAct: Compressed Activations for Memory-Efficient LLM Training
2024
-
 DNCs Require More Planning Steps
2022
-
 Coin Flipping Neural Networks